
Kimi Code
Kimi Code
无病毒无插件正式版- 117.4MB 大小
- WinALL 操作系统
- 1.1.0 版本
- 2026-10-19 更新时间
软件简介
Kimi Code是Kimi会员权益中专为开发者提供的智能编程服务,基于Kimi最新旗舰模型,通过桌面端、CLI、VS Code 扩展插件等产品形态,为开发者提供代码阅读、文件编辑、命令执行等 AI辅助能力。同时,订阅用户可获取 API Key,将Kimi Code的模型能力接入到第三方开发工具与平台。
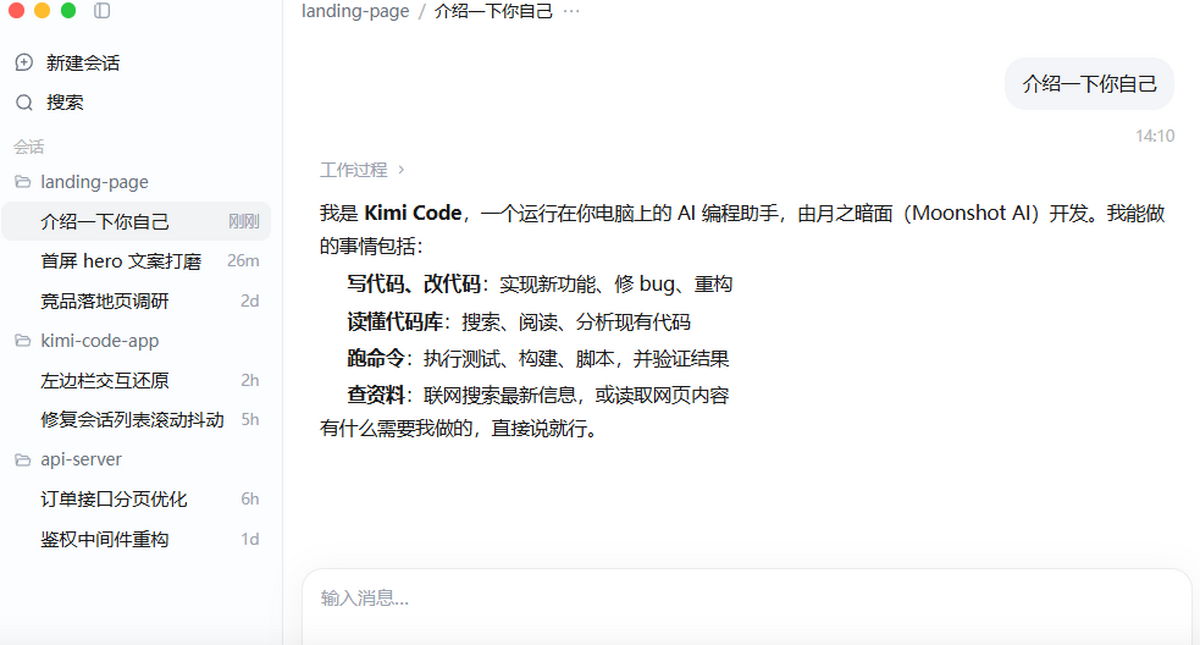
Kimi Code轻松兼容各类开发流程,更快更稳响应请求,高效地完成编程任务,适用于希望在图形界面中管理项目和会话的开发者。在桌面端中打开本地项目文件夹,与 AI 对话完成代码阅读、文件编辑、命令执行和结果验证,支持macOS、Windows与 Linux。
软件亮点
Kimi Code现已覆盖桌面端、CLI与IDE插件,轻松兼容各类开发流程,更快更稳响应请求,高效地完成编程任务。
1、桌面端
2、Terminal
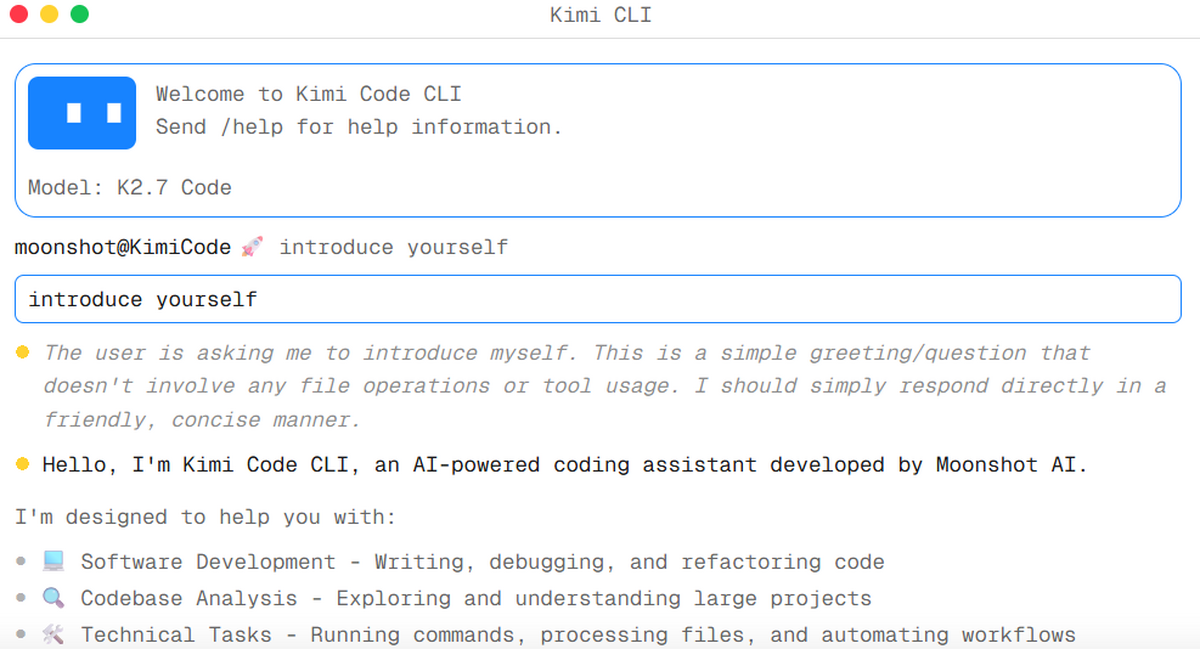
3、IDE
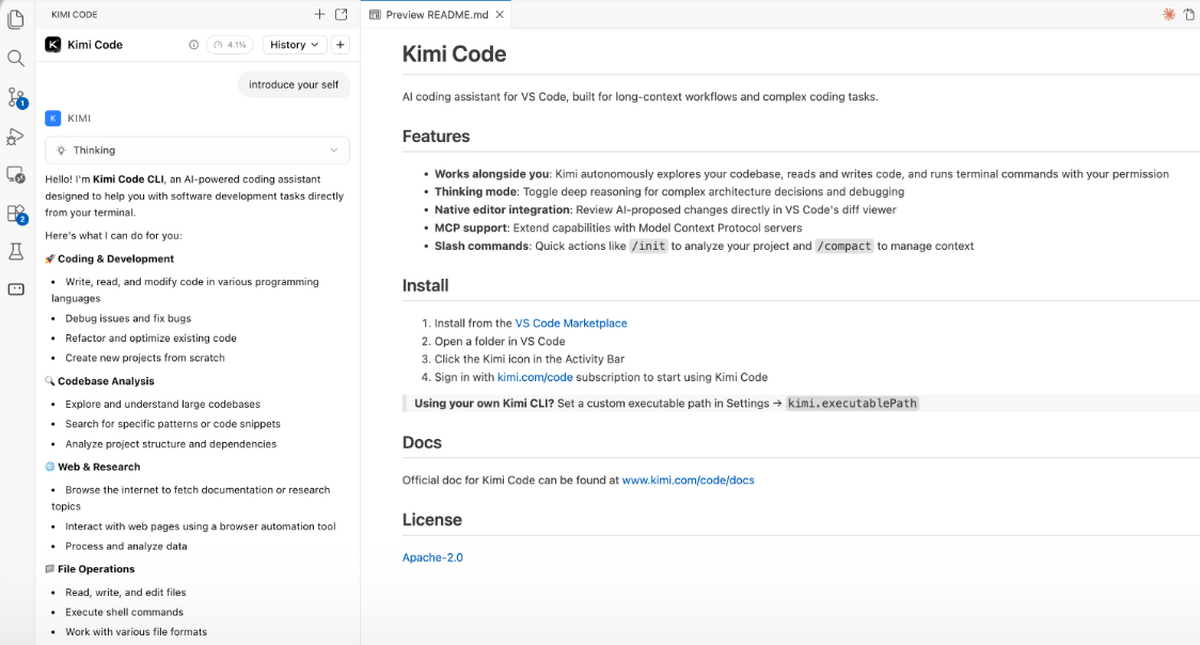
Kimi Code是什么
Kimi Code是Kimi会员权益中专为开发者提供的智能编程服务,基于Kimi最新旗舰模型,通过桌面端、CLI、VS Code扩展插件等产品形态,为开发者提供代码阅读、文件编辑、命令执行等AI辅助能力。同时,订阅用户可获取API Key,将Kimi Code的模型能力接入到第三方开发工具与平台。
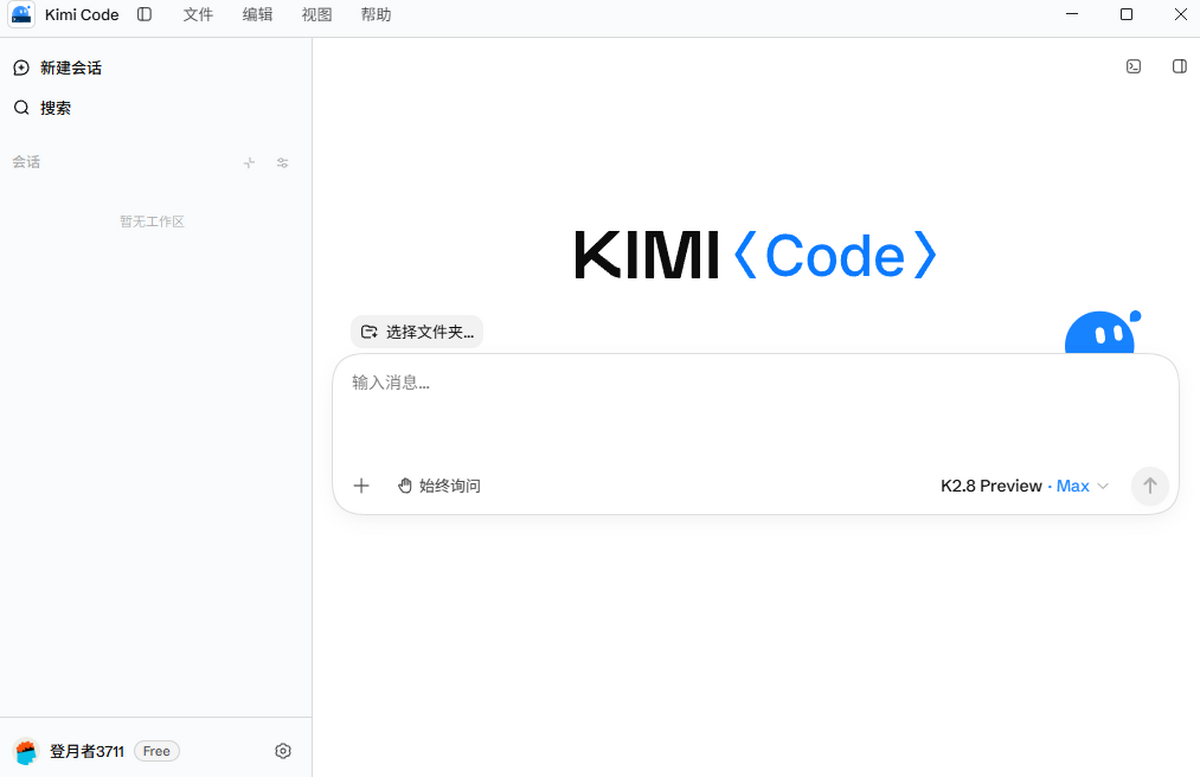
核心优势
1、模型与推理
●旗舰K3模型:搭载最强旗舰模型K3,参数规模高达2.8万亿,在长程编程、前端视觉设计、知识工作与复杂推理等核心场景表现卓越。
●1M Tokens超长上下文:支持百万级上下文窗口,可一次性完整载入大型代码库及跨模块依赖,实现全局代码理解与项目级重构。
●260 Tokens/s极速推理:提供K2.8 Preview普速版与K2.7 Code HighSpeed高速版双模式,推理速度最高可达260 Tokens/s,显著加速编码效率。
2、扩展与生态
●专业知识库(Data Source):支持接入专业级数据源,深度扩展AI Coding能力边界。
●主流工具无缝兼容:全面兼容Kimi Code CLI、Claude Code、VS Code等主流Agent工具,模型切换丝滑无感。
●实验性功能优先开放:优先体验Kimi在模型与推理领域的最新技术与产品实现,先人一步触达前沿特性。
使用方法
Q1:为什么新模型上线后消耗变多了
A:切换模型后,之前建立的上下文缓存(cache)在新模型上不再命中,这部分上下文需要重新预填充(prefill)。因此刚切到新模型时消耗会偏高。建议操作:新开session再使用新模型:能让效果更好、消耗更少。
Q2:为什么模型ID写对了还是报401
A:当请求的能力超出当前套餐权限时,服务端会返回 401,常见三种情况:
●无K3调用权限:套餐低于Moderato/Plus时无法调用k3、k3-256k(新套餐Go档无coding额度),需升级至Moderato/Plus及以上。
●无1M权限:Moderato/Plus套餐用户调用k3时支持最高256K上下文。Allegretto/Pro及更高档位支持最高1M上下文。调用k3-256k时上下文上限固定为256K。
●无高速版权限:部分套餐不含高速版,升级至Allegretto/Pro及更高档位套餐即可调用kimi-for-coding-highspeed。
Q3:为什么高速版提速不明显
A:●模型ID填错:高速版ID必须是kimi-for-coding-highspeed,填错会兜底到标准版kimi-for-coding,不报错也不加速。
●工具与脚本占了大头:高速版只加快模型输出,一次任务里工具调用(读写文件、执行命令等)与脚本执行的耗时不受影响,这部分占比大时整体提速就不明显。
Q4:如何减少因思考程度切换带来的消耗
A:切换思考程度(effort)会让已建立的上下文缓存(cache)失效,原本能命中缓存的上下文需要重新预填充(prefill)。为避免频繁触发重新预填充:
根据任务复杂度选定思考程度后,在同一会话内尽量保持一致;
确需改用不同思考程度时,新建会话再切换,而不是在长会话里反复切换。
Q5:K3(1M)与K3-256k切换注意事项
A:1、切换前先手动执行一次compact,将上下文压缩至256k以内,既能保留任务要点、会话不断档,切换后额度也更耐用。
2、若历史上下文中包含视频文件,由于K3-256k不支持视频输入,直接切换会报错,请先compact再切换。
问答
Q1:为什么新模型上线后消耗变多了
A:切换模型后,之前建立的上下文缓存(cache)在新模型上不再命中,这部分上下文需要重新预填充(prefill)。因此刚切到新模型时消耗会偏高。建议操作:新开session再使用新模型:能让效果更好、消耗更少。
Q2:为什么模型ID写对了还是报401
A:当请求的能力超出当前套餐权限时,服务端会返回 401,常见三种情况:
●无K3调用权限:套餐低于Moderato/Plus时无法调用k3、k3-256k(新套餐Go档无coding额度),需升级至Moderato/Plus及以上。
●无1M权限:Moderato/Plus套餐用户调用k3时支持最高256K上下文。Allegretto/Pro及更高档位支持最高1M上下文。调用k3-256k时上下文上限固定为256K。
●无高速版权限:部分套餐不含高速版,升级至Allegretto/Pro及更高档位套餐即可调用kimi-for-coding-highspeed。
Q3:为什么高速版提速不明显
A:●模型ID填错:高速版ID必须是kimi-for-coding-highspeed,填错会兜底到标准版kimi-for-coding,不报错也不加速。
●工具与脚本占了大头:高速版只加快模型输出,一次任务里工具调用(读写文件、执行命令等)与脚本执行的耗时不受影响,这部分占比大时整体提速就不明显。
Q4:如何减少因思考程度切换带来的消耗
A:切换思考程度(effort)会让已建立的上下文缓存(cache)失效,原本能命中缓存的上下文需要重新预填充(prefill)。为避免频繁触发重新预填充:
根据任务复杂度选定思考程度后,在同一会话内尽量保持一致;
确需改用不同思考程度时,新建会话再切换,而不是在长会话里反复切换。
Q5:K3(1M)与K3-256k切换注意事项
A:1、切换前先手动执行一次compact,将上下文压缩至256k以内,既能保留任务要点、会话不断档,切换后额度也更耐用。
2、若历史上下文中包含视频文件,由于K3-256k不支持视频输入,直接切换会报错,请先compact再切换。
点击查看更多
安装步骤
1、在本站下载最新安装包,按提示安装

2、安装进行中,完成即可使用

点击查看更多
软件截图


相关推荐


试试这些有用的软件吧 换一换
-
推荐
 豆包-工作型AI助手
工作任务Agent全新升级,新用户送30天会员
下载 -
推荐
 夸克浏览器
夸克x千问·更强大的AI浏览器
下载 -
 乐播投屏电脑版
强大的投屏性能与兼容性,让你轻松享受高清体验
下载 -
热门
 元气壁纸
支持壁纸自动切换,一键美化整理桌面,让桌面为你而动
下载 -
热门
 W优化大师
专注优化,守护电脑纯净如新
下载 -
 AI聊天助手
智能AI对话聊天机器人
下载 -
 经典老照片修复
模糊图片无损放大变清晰
下载 -
 UC网盘
重要资料放心存 精彩视频爽快看
下载 -
 爱拍压缩大师
专业极致的文件压缩器
下载 -
热门
 百度网盘AI修图
你的智能修图助手
下载 -
 汽水音乐
抖音音乐版,随时随地懂你想听
下载 -
 PP视频
海量高清视频全新体验!
下载 -
推荐
 猎豹安全浏览器9
双核安全浏览器,更安全,更快速, 更炫酷
下载 -
 清爽图片编辑
一款功能强大的图片编辑软件
下载 -
 WeMod
支持上千款PC单机游戏
下载 -
 赤兔图片压缩
一键批量压缩、无损压缩
下载